ИИ для анализа почты: находим горячих лидов
Менеджер открывает почту утром. Несколько десятков входящих. Среди них — три письма от людей, готовых купить прямо сейчас. Проблема: он не знает, какие именно AI Продавец автоматизирует исходящие звонки. Он читает всё подряд, тратит два часа, а один из горячих лидов к тому моменту уже ушёл к конкуренту, который ответил раньше. AI Покупатель Искусственный интеллект для анализа электронной почты и выявления горячих лидов решает именно эту задачу — вычленяет из потока писем тех, кто готов платить, и ставит их в начало очереди.
Почему по какие задачи автоматизировать в первую очередь с помощью ИИчтовый ящик стал узким горлышком продаж
Email остаётся одним из ключевых каналов B2B-коммуникации, и объём входящих у менеджеров по продажам продолжает расти. Но способность менеджера отличить «просто спросил» от «готов к сделке» — нет.
Горячие лиды — это контакты, которые активно проявили намерение купить: оставили заявку, явно написали о готовности к покупке или совершили близкое к сделке действие, как отмечают в BotHelp. Такие письма составляют малую долю входящего потока. Остальное — уточнения, пересылки, автоответы, шум. Человеческий глаз не может обрабатывать это быстрее, чем поток нарастает.
Анализ входящей почты для продаж в ручном режиме превращается в рулетку. Менеджер либо тратит время на всех одинаково, размазывая внимание, либо полагается на интуицию и пропускает деньги. Именно здесь нужна система, которая читает быстрее человека и думает категориями «купит / не купит».
Как ИИ разбирает письмо на молекулы
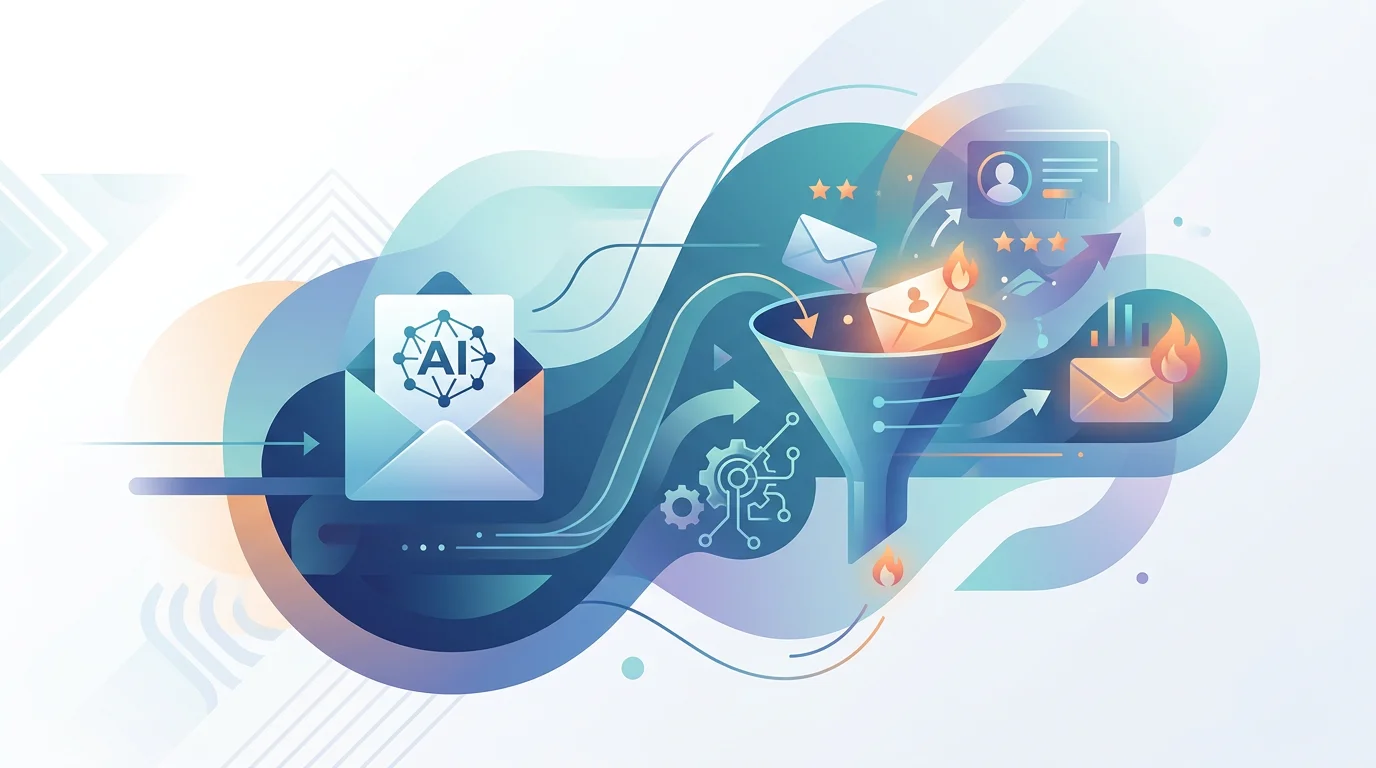
Техническая цепочка выглядит так. Сначала платформа извлекает ключевую информацию из писем и преобразует её в структурированные данные, которые можно сразу передавать в CRM, как описывают в Emagia. Из текста вытаскиваются имя, компания, роль, запрос, сроки, упоминание бюджета. Затем включается интент-анализ писем клиентов — алгоритм определяет намерение: это запрос коммерческого предложения, жалоба, информационный вопрос или прямой сигнал к покупке.
На практике работают три слоя обработки:
Классификация намерения. NLP-модель относит письмо к категории: интерес, возражение, запрос цены, отказ, нерелевантное. Это грубый фильтр, отсекающий шум.
Извлечение сущностей. Из текста вычленяются конкретные сигналы — названия продуктов, суммы, даты, упоминание конкурентов, слова-маркеры срочности. Каждый сигнал получает вес.
Скоринг. На основе совокупности признаков письму присваивается балл. Современные системы лидогенерации с ИИ анализируют тысячи поведенческих сигналов, чтобы предсказать, какой контакт с наибольшей вероятностью купит, и присваивают ему скоринговые баллы — об этом пишет LPmotor.
Результат: из всего потока входящих несколько писем подсвечены красным. Менеджер начинает день с них.
Какие сигналы в письмах указывают на готовность купить
Лидскоринг писем с помощью ИИ работает не на магии, а на признаках. Чем точнее вы их определите для своей ниши, тем точнее будет система. Вот ключевые категории сигналов, которые алгоритм ищет в тексте.
Бюджет и сроки. Классический фреймворк BANT (Budget, Authority, Need, Timeline) используется для квалификации лидов. Его критерии поддаются формализации: в тексте письма можно искать упоминание диапазона бюджета, конкретных дат, имени лица, принимающего решение — и присваивать каждому из этих сигналов числовой вес, как описано в BotHelp. Если в письме есть «бюджет до 500 тысяч», «нужно к марту», «кто принимает решение — директор» — это прямые маркеры горячего лида.
Приоритизация проблемы. Модель SNAP (Simple, iNvaluable, Align, Priority) описывает подход к работе с перегруженными информацией клиентами. Применительно к скорингу она помогает оценить, насколько срочным и высокоприоритетным клиент считает своё решение — через конкретные фразы в тексте — BotHelp. Фразы вроде «не можем больше тянуть», «ищем замену текущему подрядчику», «руководство поставило дедлайн» — сильные индикаторы.
Конкурентное сравнение. Когда лид пишет «сравниваем вас с X» или «почему вы лучше Y» — он уже на стадии выбора. Один шаг до сделки.
Эмоциональная окраска. Sentiment-анализ ловит разочарование текущим поставщиком или энтузиазм от увиденного демо. Оба сигнала — ценные.
Для разных отраслей маркеры отличаются. В B2B-SaaS горячий сигнал — «сколько стоит годовая подписка на 50 пользователей». В e-commerce — «есть ли оптовые условия при заказе от 1000 штук». ИИ обучается именно на вашей переписке, поэтому со временем ловит нюансы, которые универсальная модель пропустит.
Архитектура решения: от почтового ящика до CRM
Автоматическая квалификация лидов по email — это не отдельный инструмент, а встроенный процесс. Разберём его по шагам.
Внедрение автоматизированного извлечения данных из email включает конкретные этапы: определение требуемых полей, выбор инструмента, настройка правил и шаблонов извлечения, интеграция с почтовым сервисом, настройка формата вывода и постоянное тестирование процесса — Emagia.
На практике это выглядит так:
- Подключаете почтовый ящик отдела продаж к платформе через IMAP или API.
- Определяете поля для извлечения: имя, компания, должность, запрос, бюджет, сроки, ключевые фразы.
- Размечаете историческую переписку с тегами «горячий», «тёплый», «холодный», «нерелевантный». Это обучающая выборка. Её минимальный объём зависит от сложности задачи и баланса классов — ориентируйтесь на то, чтобы каждая категория была представлена достаточно равномерно; обычно это сотни писем.
- Настраиваете комбинированный подход: rule-based фильтры отсекают явный мусор (автоответы, рассылки), а ML-модель скорит остальное.
- Интегрируете выход со CRM. Горячий лид — автоматическая задача конкретному менеджеру с дедлайном в 15 минут.
Ключевой момент: не противопоставляйте правила и машинное обучение. Фильтры по ключевым фразам и доменам убирают значительную часть шума до того, как модель начнёт работать. Это экономит ресурсы и повышает точность.
ИИ-инструменты для работы с лидами анализируют поток входящих обращений в реальном времени, выявляя контакты с максимальной готовностью к покупке и фокусируя на них усилия продавцов. Это и есть конечная цель: не просто аналитика, а перераспределение внимания туда, где деньги.