Контроль качества звонков на базе ИИ: зачем бизнесу
Отдел качества слушает от двух до пяти звонков из ста и по ним делает выводы обо всей работе колл-центра. Остальные уходят в архив. Контроль качества звонков на основе искусственного интеллекта закрывает эту дыру: система расшифровывает и оценивает каждый разговор, а руководитель впервые видит картину целиком, а не её случайный обрезок.
Выборка в 2–5% звонков не даёт управленческой картины
При ручной проверке в колл-центре обычно прослушивают от 2 до 5% разговоров, тогда как AI-системы разбирают до 100% диалогов (MightyCall). При такой выборке вы физически не можете найти конкретный звонок, где менеджер пообещал скидку, которой нет в прайсе.
Считайте деньгами. Если из тысячи звонков в месяц двадцать заканчиваются потерей клиента из-за поведения оператора, при выборочной проверке вы увидите примерно один такой случай. Управленческого решения на нём не построить: единичный эпизод всегда списывают на неудачный день.
Полный охват меняет саму постановку задачи: вы перестаёте искать виноватых и начинаете считать частоту ошибок по типам.
Как работает скоринг звонков на базе ИИ
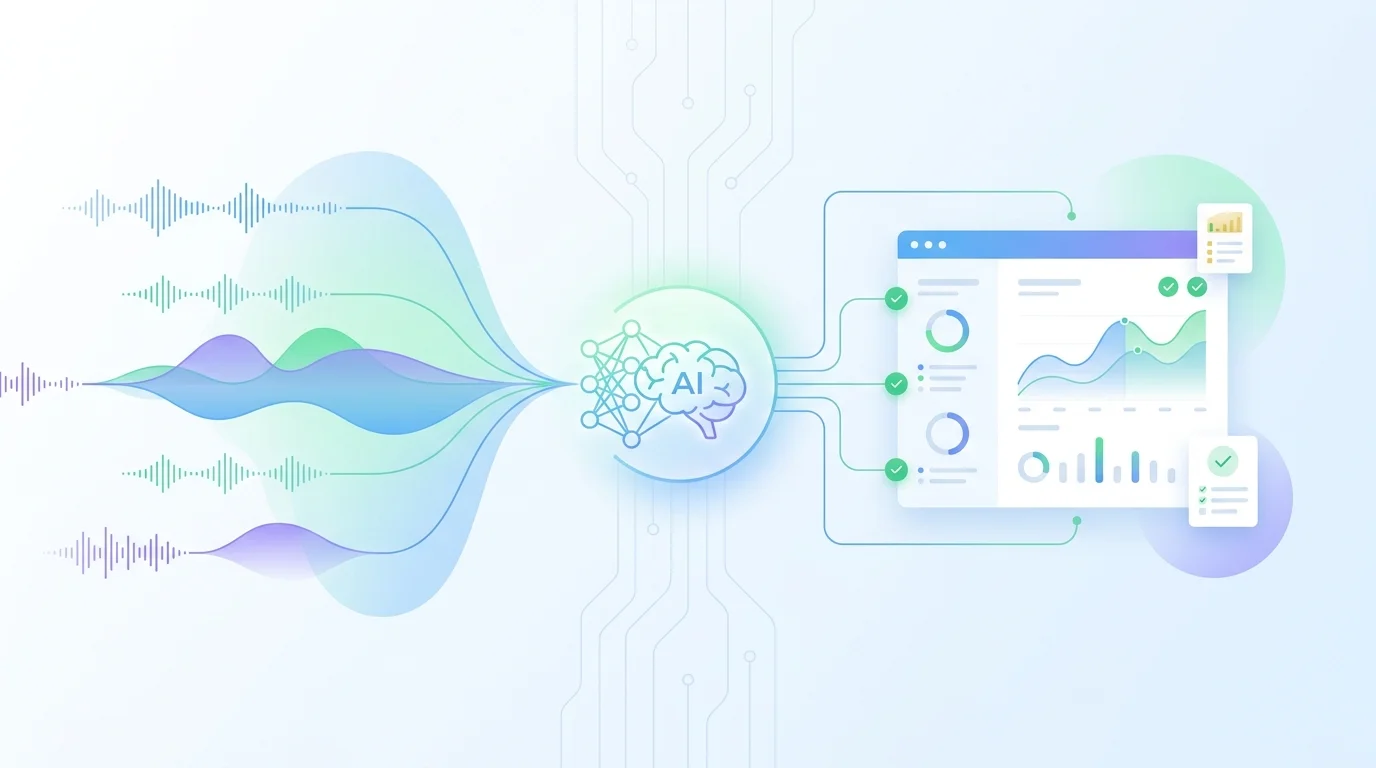
Технически процесс распадается на четыре шага: запись и транскрибация разговора, обработка текста NLP-моделями, оценка по заданным критериям, формирование отчёта для супервизора с рейтингами операторов и списком проблемных звонков (MightyCall).
Типичная архитектура AI-скоринга включает подключение к телефонии, транскрибацию моделями вроде Whisper, анализ по чек-листу на базе крупных языковых моделей и дашборды с отчётами по операторам и темам (PapaiSoft). Есть и полностью открытые сборки: пайплайн на WhisperX, Pyannote и Mistral NeMo делает транскрибацию, диаризацию (разделение реплик по говорящим) и смысловой анализ (Habr). Конкретное время обработки зависит от длины записи, аппаратной конфигурации и текущей нагрузки — универсальных цифр здесь нет.
Собрать такой стек своими силами можно. Дальше начинаются вопросы: кто держит GPU-инфраструктуру, кто дообучает модель на ваших терминах, кто отвечает, когда транскрибация начинает путать «доставка» и «достанем». Именно на этих задачах внутренние проекты обычно и останавливаются, не дойдя до промышленной эксплуатации.
Auto-QA звонков и скоркарта: сколько критериев нужно
Автоматическая оценка качества звонков живёт на чек-листе. В рабочей конфигурации система разбирает диалог по 15–20 параметрам, выставляет Да/Нет/Частично и считает итоговый QA-score (Речка AI). В скоркартах каждому критерию присваивается вес, а итоговая оценка оператора считается по формуле с положительными и отрицательными баллами под внутренние требования компании (WonderScribe).
Логика группировки бывает и блочной. В CallScore AI каждый разговор поддержки оценивается по 7 блокам: начало, обработка запроса, решение вопроса, эскалация, письменные контакты, дополнительные критерии, завершение, а итог выводится по цветовой шкале от «Отлично» до «Неприемлемо» (Libra Hospitality).
Практический вывод простой. Скоркарта из трёх пунктов ничего не объясняет, из пятидесяти становится неуправляемой: операторы не запоминают требования, а супервайзер не понимает, за что упал балл. Диапазон 15–20 критериев на практике оказывается рабочим компромиссом; веса стоит пересматривать по мере смены приоритетов — сегодня это удержание клиента, через полгода допродажа.
Оценка соблюдения скрипта с помощью ИИ и проверка по регламентам
Формально скрипт может быть соблюдён идеально, а клиент всё равно уйдёт недовольным. Поэтому AI-платформы разбирают 100% входящих и исходящих звонков более чем по 15 метрикам, включая вежливость, соблюдение скриптов и эмоциональную окраску беседы (РБК Компании).
Современные системы контроля качества не ограничиваются тоном: они сверяют ответы операторов с внутренней базой знаний из тысяч статей, проверяя корректность решения и соблюдение регламента (Libra Hospitality). Оператор был вежлив, уложился в SLA и дал клиенту неверную инструкцию. Ручной QA такой звонок пропустит с высоким баллом, потому что проверяющий сам не знает регламент по этому продукту наизусть.
Для банка, страховой или медицинского центра это прямая работа с риском: неверно озвученное условие договора стоит дороже, чем годовая подписка на речевую аналитику.
Что меняется в работе отдела качества
Единая скоркарта и одна модель применяются ко всем звонкам одинаково, поэтому влияние человеческого фактора со стороны супервайзоров падает (WonderScribe). Оценка перестаёт зависеть от того, устал проверяющий к пятнадцатому звонку или симпатизирует конкретному сотруднику.
Меняется и структура рабочего дня. Система сама сортирует диалоги, подсвечивает проблемные случаи и считает итоговый балл, освобождая супервайзера от массового прослушивания в пользу коучинга (Habr). Разговор с сотрудником и разбор его ошибок остаются за руководителем.
Разумный сценарий запуска: AI работает первым контуром. Система расшифровывает звонки, размечает их по QA-rubric, подсвечивает риски эскалаций и готовит подсказки для коучинга, а решение по спорным случаям принимает человек (Woghan). Такая схема снимает и главное возражение операторов: балл машины не превращается автоматически в приказ о штрафе.
Где внедрение спотыкается
Три места ломаются чаще всего, и все три стоит проработать до запуска, а не после.
Первое: качество аудио. Шумный опенспейс, гарнитура за 500 рублей, мобильная связь в подвале дают транскрипт, по которому не оценить ничего. Решение здесь техническое: стандарт записи должен быть прописан до того, как модель увидит первый звонок. Иначе мусор на входе даст мусор в отчёте, и команда разочаруется в инструменте раньше, чем успеет его настроить.
Второе: калибровка. AI-оценки нужно сопоставлять с ручными на контрольной выборке — иначе скоркарта живёт своей жизнью, а руководитель ей не доверяет. Калибровка — это не разовая процедура: её стоит повторять после каждого изменения чек-листа и при смене состава операторов.
Третье: отраслевая лексика. Модель, не видевшая ваших названий тарифов и продуктов, будет ошибаться в самых важных местах. Дообучение или хотя бы глоссарий с ключевыми терминами нужно закладывать в план внедрения, а не оставлять на потом.
Отсюда и ответ на вопрос «делать самим или брать готовое». Внутренняя команда оправдана, когда у вас сотни операторов, требования к on-premise и штат ML-инженеров. Во всех остальных случаях дешевле подключить сервис, который уже прошёл этап настройки чек-листов, интеграции с телефонией и CRM и калибровки на живых записях.
Не превратится ли AI-скоринг в тотальный надзор, после которого операторы начнут увольняться?
Зависит от того, как вы используете балл. Если модель работает первым контуром, а финальное решение по спорным звонкам остаётся за человеком (Woghan), сотрудник видит в отчёте конкретную ошибку и способ её исправить. Та же система, привязанная напрямую к штрафам, со временем превращается в инструмент саботажа: операторы учатся проходить чек-лист, забыв про клиента.
Зачем платить за ИИ, если отдел качества и так справляется?
Он справляется с 2–5% разговоров (MightyCall). Расширение ручного охвата до 100% потребует кратного увеличения штата QA — без гарантии единых стандартов оценки между проверяющими.
Можно ли доверять оценке модели, если она ошибается?
Ошибается и супервайзер, только его ошибки никто не измеряет. У модели точность проверяема: берёте выборку, сравниваете AI-оценки с ручными, считаете расхождения по каждому критерию скоркарты и подкручиваете формулировки. Такую сверку стоит повторять после каждого изменения чек-листа.
Что делать дальше
Начните с малого: соберите чек-лист из 15 критериев под свою воронку, выгрузите записи за последний месяц и прогоните их через пилот. Цифры по частоте ошибок вы получите за неделю. На их основе уже можно принимать решения по обучению операторов, настройке весов и приоритетам следующего квартала.