Звуковой анализ звонков: точность эмоций до 87,82%
Руководитель отдела продаж прослушивает в лучшем случае несколько записей в день. Остальные разговоры, где клиент засомневался или менеджер пропустил скрипт, проходят мимо. Ниже разбираю, как ИИ разбирает звонок на слова, интонацию и паузы, какие цифры точности стоит принимать всерьёз и где система ошибается.
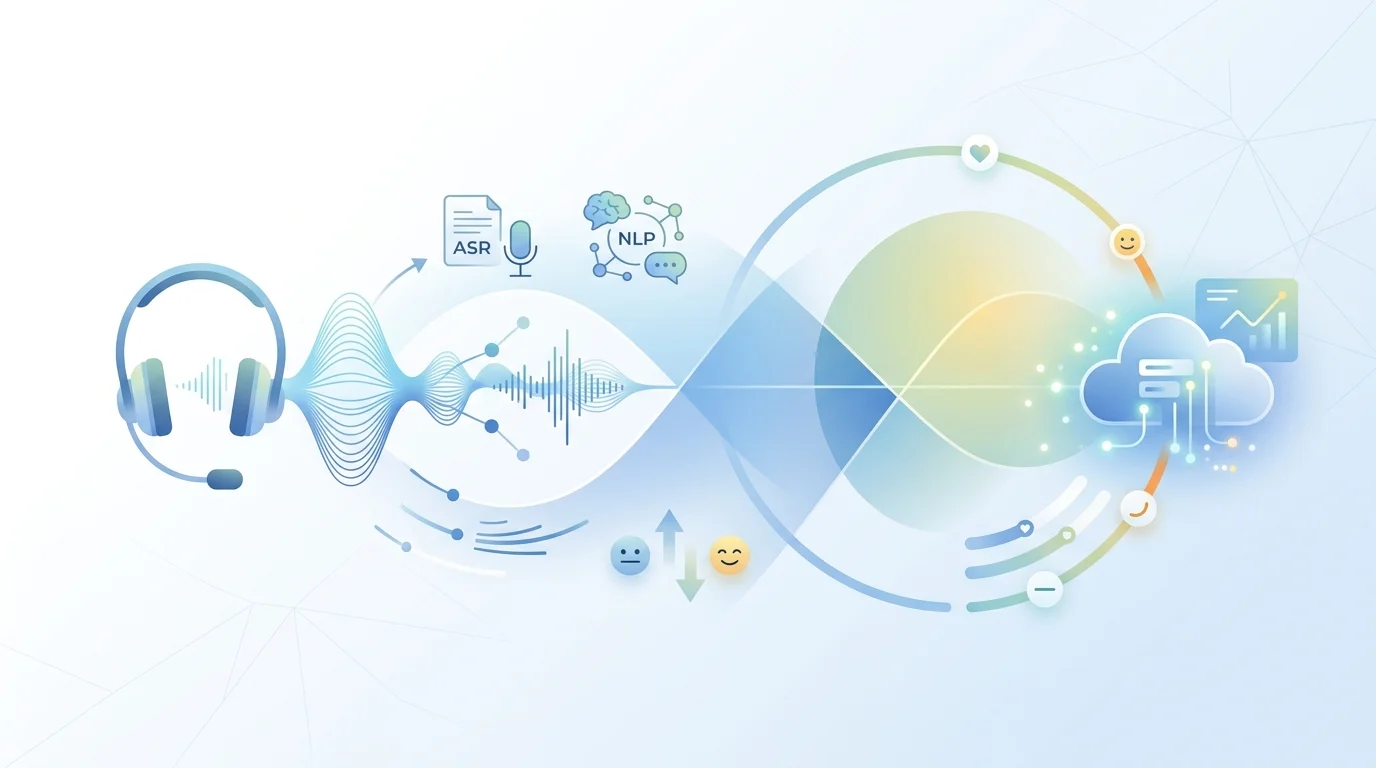
- Звонок проходит цепочку: запись → очистка от шума → ASR → разделение спикеров → NLP → отчёт.
- Лучший результат классификации эмоций на русском датасете Dusha: 87,82% (модель WavLM). На другом наборе данных он падает до 81%.
- Эмоциональный тег показывает класс, к которому модель отнесла голос. Что клиент чувствовал на самом деле, он не измеряет.
- Перед покупкой проведите пилот на своих записях с эталонной разметкой.
Как ИИ превращает звонок в данные?
Запись проходит пять операций, и каждая может испортить результат следующей. Ошибка на входе дальше только растёт.
Шаг 1. Запись и подавление шумов: из дорожки убирают фон салона, трассы и эхо. Шаг 2. Транскрибация звонков через распознавание речи ASR: звук превращается в текст. Шаг 3. Разделение спикеров (diarization): система определяет, где говорит менеджер, а где клиент. Шаг 4. Обработка естественного языка NLP: поиск тем, возражений, фраз из скрипта, анализ тональности текста. Шаг 5. Отчёт в CRM: теги, оценка по чек-листу, флаги для проверки.
Технология уже массовая. В 2024 году свыше трети российских компаний, использующих ИИ, обрабатывали текст или звуковые данные, включая распознавание речи (ИСИЭЗ НИУ ВШЭ). Выборка исследования: более 15 тыс. крупных и средних организаций.
Что система слышит кроме слов?
Кроме текста модель считывает паравербальные признаки: темп, высоту голоса, громкость, паузы и перебивания. Они говорят о том, как сказаны слова, и текстовый анализ их не видит.
Фраза «да, интересно» с ровным темпом и фраза «да, интересно» после долгой паузы и на пониженном тоне в расшифровке выглядят одинаково. Акустика их различает. Перебивания показывают, кто ведёт разговор: менеджер, который постоянно перебивает, теряет клиента ещё до цены.
Иногда «звуковым анализом звонка» называют задачу из школьной фонетики. Нормативное ударение в слове: звоно́к, на второй слог. Транскрипция [звано́к]: 6 букв и 6 звуков, безударная «о» звучит как [а].
| Звук | Характеристика |
|---|---|
| [з] | согласный, звонкий, твёрдый |
| [в] | согласный, звонкий, твёрдый |
| [а] | гласный, безударный |
| [н] | согласный, сонорный, твёрдый |
| [о́] | гласный, ударный |
| [к] | согласный, глухой, твёрдый |
Можно ли измерить эмоции клиента по голосу?
Отнести голос к классу «злость», «радость» или «нейтрально» модель может, и довольно точно. Узнать, что человек чувствовал, она не может.
В исследовании 2024 года сравнивали Wav2vec 2.0, HuBERT и WavLM. Лидер, WavLM, показал Accuracy 0,8782 на Dusha и 0,81 на RESD (исследование распознавания эмоций). Стоило сменить датасет, и модель потеряла почти семь пунктов.
Ваши звонки отличаются от обоих датасетов сильнее, чем они отличаются друг от друга. Сколько процентов останется на записях автосалона или клиники, заранее не скажет никто. Я честно не знаю ни одной независимой проверки на реальных продажах в России.
Контекст ломает классификацию. Клиент громко смеётся над шуткой менеджера, и модель ставит ему «агрессию». Ирония в тексте даёт «позитив». Эмоциональный тег пригоден как сигнал для проверки человеком. Выносить по нему вердикт рано.
Какие метрики проверять при выборе системы?
Цифру из презентации «точность 9X%» проверяйте на своих записях. Чек-лист:
- WER (доля ошибок в словах) на ваших звонках, отдельно для названий моделей, услуг и цен.
- Precision и recall тегов: сколько найденных нарушений настоящие и сколько настоящих система пропустила.
- Diarization error rate: как часто реплики клиента приписываются менеджеру.
- Согласие оценщиков: если два ваших РОПа по-разному оценивают один звонок, модель не будет точнее их.
- Задержка анализа: отчёт через час помогает перезвонить клиенту сегодня, отчёт через неделю годится только для статистики.