Решения для бизнеса с ИИ: обзор архитектур
Вы запустили пилотный ИИ-проект, он показал результат на демо, а в продакшне развалился. Знакомо. Проблема не в модели — проблема в архитектуре, которой у вас нет. Этот текст — разбор того, как устроены решения для бизнеса с ИИ на уровне архитектур, чтобы ваш следующий проект дожил до прибыли.
7 слоёв ИИ-системы: от данных до мониторинга
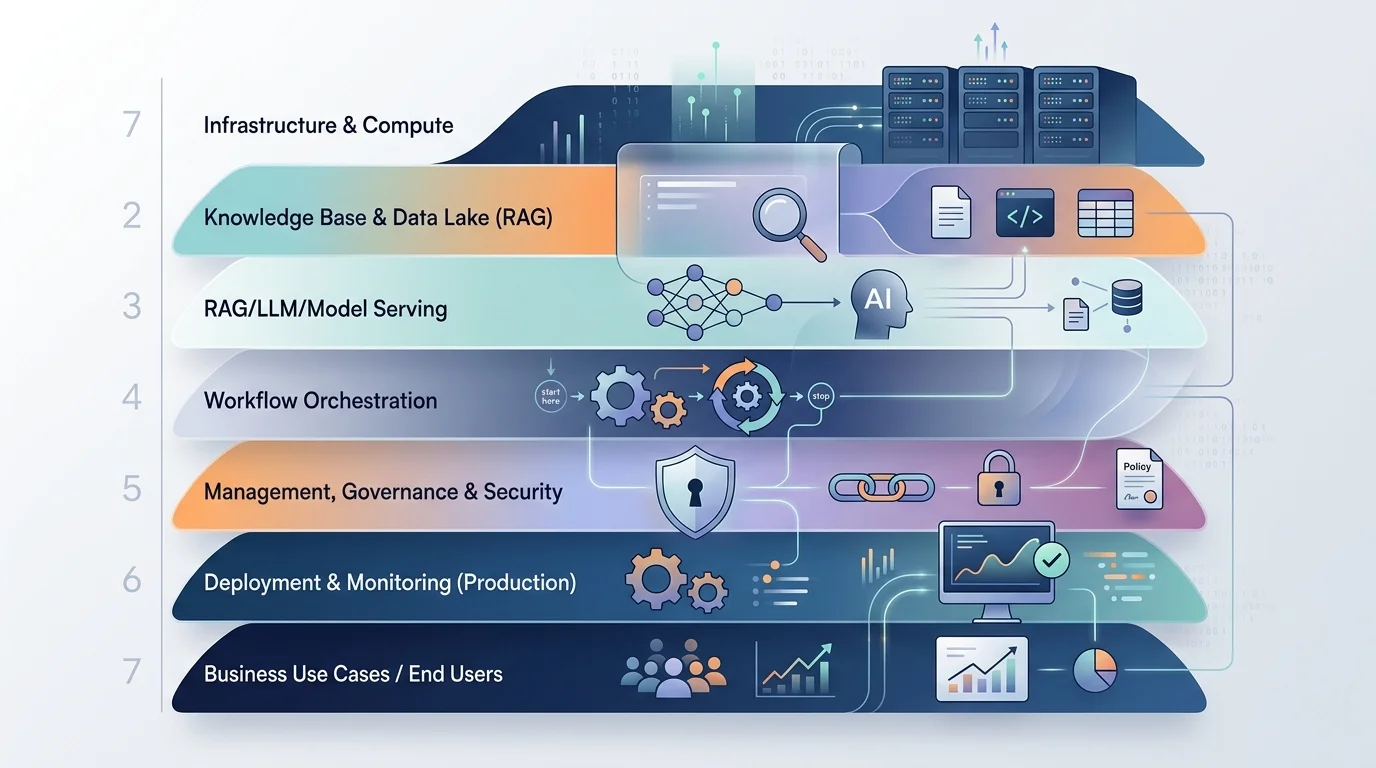
Корпоративный ИИ — это не нейросеть в вакууме. Это инженерная конструкция. Согласно разбору Epsilon Metrics, архитектура корпоративного ИИ включает 7 слоёв: от источников данных до мониторинга. Каждый слой решает свою задачу, и пропуск любого из них — гарантия провала на масштабировании.
Нижний слой — источники данных: CRM, ERP, внешние API. Далее идёт слой обработки и нормализации. Потом — хранение, модели, оркестрация ИИ workflow, интерфейсы, и наверху — мониторинг ИИ в продакшне. Каждый слой зависит от предыдущего: пропустите один — и всё, что идёт после, работает на нестабильном основании.
По данным исследований, большинство компаний уже используют ИИ в бизнес-функциях, но при этом меньше половины имеют стратегию управления им. То есть значительная часть компаний внедряют технологию без понимания, как 7 слоёв ИИ-системы связаны между собой. Результат предсказуем — пилоты, которые не масштабируются.
RAG в бизнес-ИИ: зачем нужна база знаний
RAG (Retrieval-Augmented Generation) — это когда модель не выдумывает ответ из своих весов, а сначала ищет релевантный контекст в вашей базе знаний ИИ, а потом формулирует ответ на его основе. Разница как между сотрудником, который фантазирует, и сотрудником, который сначала открывает регламент.
Для корпоративного применения RAG в бизнес-ИИ решает критическую проблему: галлюцинации. Когда модель отвечает клиенту неправильную цену или ссылается на несуществующий пункт договора — это прямые убытки. RAG привязывает генерацию к вашим документам, политикам, базам данных.
Архитектурно это отдельный слой между хранилищем данных и моделью. Он включает векторную базу, пайплайн индексации документов и логику ранжирования. Без него корпоративный ИИ генерирует ответы в отрыве от вашей реальности. С ним — работает с вашими актуальными данными.
Оркестрация ИИ workflow: почему одна модель не справится
Бизнес-процесс — это цепочка. Получили заявку, классифицировали, обогатили данными, приняли решение, уведомили клиента. Одна модель не покроет всю цепочку. Нужна оркестрация ИИ workflow — система, которая управляет последовательностью вызовов разных моделей, API, правил и проверок.
Корпоративный рынок ИИ-платформ растёт: инвестиции идут не в отдельные модели, а в инструменты, умеющие связывать компоненты. Agentic AI, мультимодальные пайплайны, цепочки принятия решений — всё это требует оркестратора.
На практике это выглядит так: входящее письмо → классификатор определяет тип → RAG подтягивает контекст → генеративная модель формирует ответ → валидатор проверяет на соответствие политикам → ответ уходит клиенту. Каждый шаг — отдельный компонент. Оркестратор следит, чтобы цепочка не порвалась, обрабатывает ошибки, логирует результаты. Без этого слоя у вас не система, а набор скриптов.
Безопасность ИИ: корпоративный уровень требований
Безопасность ИИ в корпоративном контексте — это не про «пароль посложнее». Это контроль доступа к данным, на которых обучается и работает модель. Это предотвращение prompt-инъекций. Это аудит того, какие данные попадают в контекст модели и кто видит результаты.
Российский рынок генеративного ИИ составляет 58 млрд руб в 2025 году. При таких объёмах утечка корпоративных данных через ИИ-систему — не теоретический риск, а вопрос времени, если безопасность не заложена в архитектуру.
Что закладывать на уровне архитектуры: изоляцию данных между тенантами, шифрование контекста, ролевую модель доступа к базе знаний ИИ, логирование всех промптов и ответов, возможность полного удаления данных клиента из векторных хранилищ.
Рассмотрим, как это работает на практике. Ролевая модель доступа означает, что менеджер по продажам видит в ответах ИИ только документы своего раздела базы знаний — не HR-политики, не финансовые регламенты. Это реализуется через фильтрацию на уровне векторного поиска: к каждому документу при индексации присваиваются метки доступа, и запрос пользователя выполняется только в пределах разрешённого ему пространства. Логирование промптов, в свою очередь, позволяет ретроспективно восстановить, какие данные были переданы в модель при конкретном запросе — это необходимо и для аудита, и для расследования инцидентов. Если ваш ИИ-вендор не может объяснить, как реализован каждый из этих механизмов — ищите другого вендора.
Мониторинг ИИ в продакшне: что измерять
Модель деградирует. Это не баг, это свойство. Данные меняются, распределения сдвигаются, пользователи находят способы ломать промпты. Без мониторинга ИИ в продакшне вы узнаете о проблеме от разъярённого клиента, а не из дашборда.
Минимальный набор метрик: латентность ответа, процент отказов, drift данных, качество ответов (через оценку пользователей или автоматические чекеры), стоимость за запрос. Для RAG-систем добавляется relevance score — насколько найденные документы релевантны запросу.
Мониторинг — верхний из 7 слоёв, но проектировать его нужно первым. Потому что если вы не знаете, что будете измерять, вы не заложите нужные логи и метки в нижние слои. Это как строить дом без проекта канализации — потом долбить стены дороже, чем сделать сразу.
Как перейти от пилота к масштабу: практический чеклист
Компании, у которых нет стратегии управления ИИ, как правило, застревают на пилотах. Переход к масштабу требует архитектурного мышления, а не очередного PoC.
Чеклист аудита текущего ИИ-пилота перед масштабированием:
- Определены ли все 7 слоёв или модель работает «напрямую» с данными
- Есть ли оркестрация или цепочка держится на одном скрипте
- Реализован ли RAG или модель отвечает «из головы»
- Заложена ли безопасность или данные летят в открытом виде
- Настроен ли мониторинг или вы проверяете качество вручную раз в неделю
Если на три и более пунктов ответ «нет» — вы не готовы к масштабированию. Это точка, в которой дешевле перестроить архитектуру сейчас, чем чинить её под нагрузкой позже.
Отдельный вопрос — интеграция с существующей инфраструктурой. На российском рынке это, как правило, означает связку с 1С, Битрикс24 и внутренними учётными системами. Это не частный случай, а типовая задача: в большинстве компаний ИИ-система будет работать не в изоляции, а поверх уже сложившегося стека. Архитектура должна предусматривать адаптеры и промежуточные слои на этапе проектирования, а не добавляться задним числом в виде точечных интеграций.
Если большинство компаний уже используют ИИ, а стратегия есть меньше чем у половины — значит ли это, что остальные обречены на провал?
Не обречены, но заплатят дороже. Отсутствие стратегии означает реактивный подход: проблемы решаются по мере появления, архитектура обрастает костылями, технический долг растёт. Компания не умрёт — но на тот же результат уйдёт значительно больше времени и денег, чем у той, которая заложила архитектуру на старте.
RAG звучит как очередной хайп. Можно ли обойтись файн-тюнингом модели на корпоративных данных?
Можно. Если вас устраивает, что при каждом обновлении документации нужно переобучать модель, тратить недели и бюджет на GPU. RAG позволяет обновлять базу знаний ИИ за минуты — загрузили новый документ, проиндексировали, модель уже отвечает по нему. Для динамичного бизнеса, где регламенты и прайсы меняются каждый месяц, файн-тюнинг — это дорогая неповоротливость.
Сколько реально стоит построить полноценную ИИ-архитектуру?
Стоимость сильно зависит от масштаба, стека и состава команды — универсальных цифр здесь нет. Полезнее задать другой вопрос: сколько стоит ручная обработка тех же процессов за год? Именно это число определяет, при каком бюджете на архитектуру проект окупается.
Итоги
Разница между успешным внедрением и провалом лежит не в выборе модели, а в проектировании системы целиком. Семь слоёв, RAG, оркестрация, безопасность, мониторинг — это не опции, это обязательная программа.
Пройдите по чеклисту выше, определите пробелы, закройте их до масштабирования.